AI 与软件的实用决策指南
选择模型、验证软件与规划交付的技术指南。
搜索全部文章
搜索文章全文。
没有找到相关文章。换个关键词,或选择一个主题。
最新文章
最新比较、实用指南与工程经验。
 交付与 QA
Browser Use 与 Playwright:超时后如何核验已登录业务动作
为需要登录的业务流程选择 Browser Use 或 Playwright。通过独立验收处理持久登录、不确定提交与重试。

 AI 与智能体
OpenAI Decisions API:置信度、拒绝回答与任务路由
面向公开测试版的任务路由指南:了解实际请求结构、逐问题拒绝处理、概率阈值,以及输入 token 成本的完整计算示例。
 AI 与智能体
Claude Model Router:到底何时切换模型?
模型推荐变了,当前会话却可能保持不变。对比 Claude Code 原生设置、路由 Hook 与服务商网关,核实真正执行任务的模型。
 交付与 QA
AI 编程时代的软件护城河:谁来维护你构建的系统?
功能越来越容易复制,谁对上线后的业务结果负责?本文分析 AI 生成软件的运维成本、自建与采购的选择,以及上线前必须明确的七项责任。
 AI 与智能体
Cloudflare Clef 与 Jev:价格、基准测试与迁移
Clef 为类似 Jev 的决策 API 带来开放权重与图像输入。但价格、置信度含义和 Flash 的任务表现,都需要在迁移前单独验证。
 AI 与智能体
Context Language Models 与上下文压缩:应该如何试点?
智能体应该自行编辑上下文吗?比较 CLM 与上下文压缩,核查实际运行框架和许可,并测试关键事实丢失、缓存残留与恢复能力。
 AI 与智能体
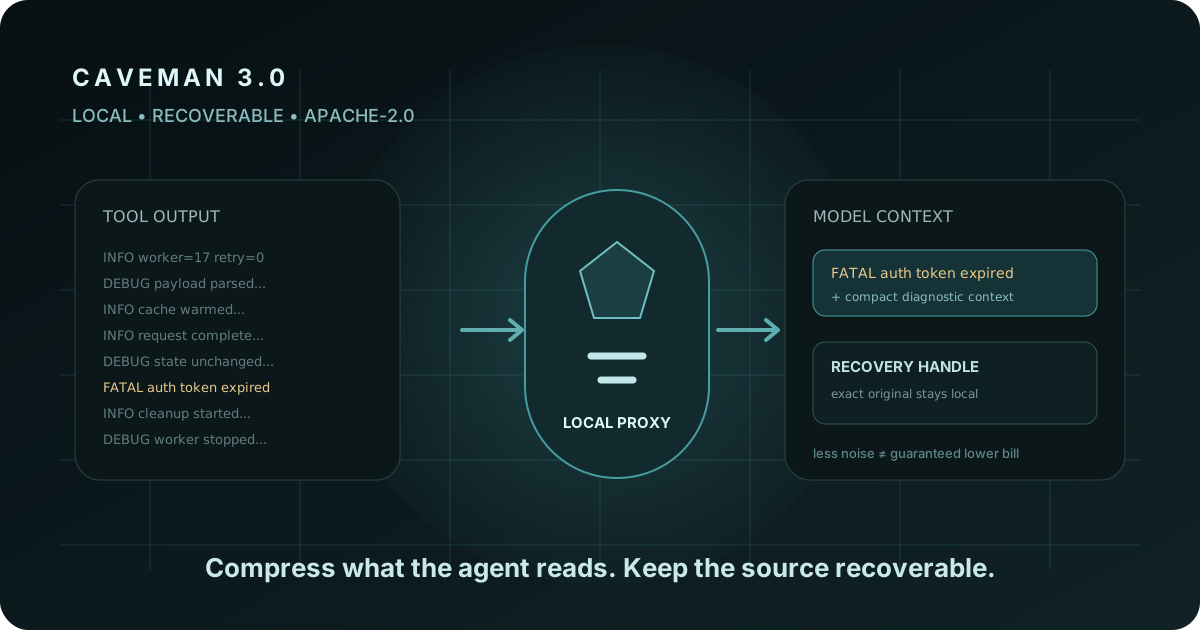
Caveman 3.0 与 Claude Code:本地输入压缩、原文恢复与基准
Caveman 3.0 在编码智能体和模型之间加入 Apache-2.0 压缩层。本文核查本地代理、原文恢复、caveman learn 与 33.2% 输入 token 基准。
 AI 与智能体
LiteLLM Lens:用 SQL 与 API 分析智能体 Trace
从查看单次运行转向调查重复问题:理解 LiteLLM Lens、ClickHouse SQL、安全 API 访问,以及从证据到回归测试的完整路径。
 交付与 QA
ChatGPT Dots + GitHub:从缺陷报告到经过审查的 PR
把缺陷报告转化为可审查的修复,而非未经验证的合并。包含 Dots 任务说明、测试证据要求和明确权限边界的实用工作流。
只收重要内容
获取下一篇一线笔记
有新文章时发送一封简短邮件,不使用跟踪像素,也不发送填充内容。