本文内容
LangSmith Trace 保留:采样、评估与成本
头图:© 2026 Wavect。
LangSmith 的上传采样、评估器采样和 Trace 保留期是三项独立控制。上传采样决定哪些数据进入平台,评估器采样决定哪些记录接受评分,保留期则决定这些证据还能查询多久。降低评估比例,不会减少已经上传的 Trace 数量。
当生产团队追问追踪账单为何上涨、评分为何不再出现,或某次事故为何已无法复现时,这个区别就很关键。有效的配置需要明确证据保留窗口、实际接受评分的样本范围,以及每项计费操作的预算。
资料核对日期:。本文综合官方文档和当前公开定价。流量与账单示例均为假设条件下的计算。我们没有测试付费 LangSmith 账户,也没有测量客户的生产流量。
LangSmith 如何计算一条 Trace?
Run 是一次操作,例如模型调用或工具调用。Trace 将根 Run 及其子 Run 组织为一条调用链;Thread 则将同一对话中的多条 Trace 归为一个线程。LangSmith 的可观测性概念文档解释了这些关系。十轮对话可以包含十条 Trace,而其中一轮也可能包含多个子 Run。
根据计费用量定义,一个根 Run 及其子 Span 合计为一条 Trace,并非每次模型调用都各算一条。平台还记录数据接收时间,因此延迟上传的记录,其接收时间可能与实际执行时间不同。核对数量时查看用量页面,核对实际收费时查看账单。
LangSmith 可以独立于 LangChain 对代码进行追踪。如果你正在选择执行框架,可以先阅读我们的LangChain Deep Agents 评测。本文关注的是追踪与评估层该如何配置和运行。
LangSmith 的 Trace 保留期是14天、180天,还是400天?
当前 SaaS 的基础保留期为14天,延长保留期最高为180天。Cloud 更新日志将新的180天上限生效日期列为2026年9月14日。该变更适用于新 Trace,已有 Trace 不受影响。这项 SaaS 调整也不改变自托管或 BYOC 部署的保留期。
默认保留策略属于追踪项目,或由该项目支持的智能体环境。修改默认值只影响后续 Trace。关闭评估器的延长保留选项,也不会改变已经升级的 Trace。因此,应在新的生产数据流开始之前确定保留策略。
先明确一个具体的证据窗口:事故发生多久以后,团队仍可能需要原始工具结果、提示词和响应?保留汇总图表与复原某一次执行,是两种不同的需求。选择能够支持工作流的最短保留期,并记录需要更长存储时间的例外情况。
哪些 LangSmith 操作会延长 Trace 保留期?
应检查具体操作自己的设置。手动添加评论与通过自动审查规则处理 Trace,不一定产生相同的存储结果。
| 操作 | 保留策略行为 | 需要检查什么 |
|---|---|---|
| 在界面中添加反馈或备注 | 保留档位不变 | 不要认为人工评论会自动保住这条 Trace。 |
| 通过 API 或 SDK 添加反馈 | 明确请求后才延长 | extend_trace_retention=true,TypeScript 中为 extendTraceRetention: true。 |
| 手动加入标注队列 | 默认不升级 | 审查截止日期应早于现有证据到期时间。 |
| 在线评估器 | 初始启用延长保留;默认使用基础保留的项目可关闭 | Advanced → Extend trace retention。 |
| 标注队列自动化 | 默认开启延长保留,可关闭 | 该操作已保存的保留期开关。 |
| 数据集或 Webhook 自动化 | 默认关闭延长保留,可开启 | 该操作已保存的开关,以及其他匹配规则。 |
| 明确的保留期操作 | 升级匹配的 Trace | 即使匹配的是子 Run,也可能升级整条 Trace。 |
| 开启延长保留的 Thread 规则 | 升级匹配线程中的每一条 Trace | 计算受影响的 Trace 数量,不能只计算对话数。 |
用量与计费指南说明了手动反馈、SDK 显式延长保留,以及已有 Trace 的处理方式。自动化指南中各操作的具体设置区分了队列、数据集和 Webhook 的默认值。其 Thread 规则也解释了为什么选中一次对话,可能触发多条 Trace 升级。
若希望评估时不延长保留期,可按管理评估器 Trace 保留期中的步骤操作:将评估器绑定到默认采用基础保留的追踪项目或环境,打开 Advanced(高级设置),取消勾选 Extend trace retention(延长 Trace 保留期)。该设置适用于后续 Trace 级和 Thread 级评分。如果项目默认采用延长保留,该选项会被锁定。其他匹配规则仍可能升级同一条 Trace。
部分文档导言仍笼统地描述自动升级。上表采用各操作的详细设置,以及评估器明确提供的关闭选项。上线时应核实保存后的配置,不能把新建规则的默认值当成永久策略。
Trace 采样与评估器采样:实际有多少执行接受评分?
SDK 的Trace 采样控制在上传前选取一部分记录。对于已经通过 LangSmith SDK 或 LangChain 接入追踪的应用,下面的环境变量将目标采样率设为10%:
export LANGSMITH_TRACING_SAMPLING_RATE=0.10它不会配置直接调用 REST API 的程序,也不会自动为应用添加追踪埋点。采样具有随机性。对账时应使用实际成功接收的记录数,不能假设每个月的结果都恰好等于配置比例。
在线评估器采样发生在后续阶段,面向的是通过其筛选条件的 Run。评估器配置指南明确说明了这个符合条件的样本范围。是否只选择根 Run 也很重要:若筛选条件包含多个子 Run,一条 Trace 就可能触发多次评估。
| 阶段 | 假设 | 数量 |
|---|---|---|
| 应用执行 | 指定工作流内的全部执行 | 1,000,000 |
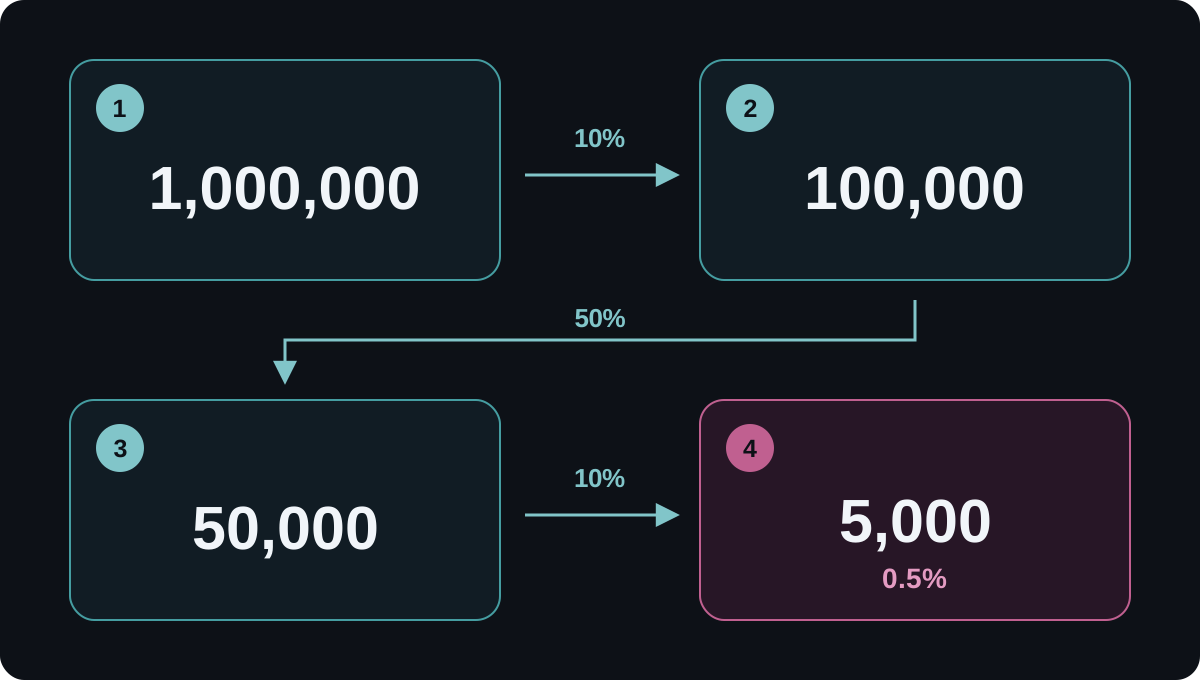
| 已接收的 Trace | 实际采样比例为10%,且全部成功上传 | 100,000 |
| 符合条件的根 Run | 其中一半通过评估器筛选条件 | 50,000 |
| 完成评分的 Run | 实际抽取符合条件根 Run 的10%,且所有评估成功 | 5,000 |
| 特意选择的长期保留子集 | 从这5,000条评分记录中选择1,000条不同的 Trace | 1,000 |
评估器覆盖了应用执行总量的0.5%:10% × 50% × 10%。它覆盖的是已接收 Trace 的5%。这两个分母都不能直接替换为“评估了10%”。这些百分比描述的是示例中实际得到的数量,配置中的采样率则描述预期比例。
保留规则可以延长已上传失败记录的存储时间,却无法找回上传前就被采样丢弃的执行。如果某个指定工作流要求完整追踪,应在执行前通过条件追踪和适当配置的客户端明确策略。不要声称随机采样能够捕获未来的每一次错误。
我们建议分别统计应用执行数、已接收 Trace 数、符合条件的根 Run 数、成功评分数和失败评估数。任何质量百分比都应同时注明筛选条件和评估器版本。关于评分器的有效性和评分规则设计,请参阅现有的LLM 评估成本与 ROI 指南。
这套 LangSmith 保留策略需要多少钱?
当前自助订阅定价页列出:1 LSU 等于1美元,一条基础 Trace 为0.005 LSU,升级到延长保留额外收取0.0025 LSU。也就是每1,000条基础 Trace 收费5美元,每1,000次升级另收2.50美元。Plus 每个席位每月39美元,包含10,000条基础 Trace;Developer 包含5,000条基础 Trace 和一个免费席位。
将这些价格用于上面的示例。假设使用一个 Plus 席位,将其包含的10,000条基础 Trace 额度全部分配给这个应用,且没有额外抵扣额度、折扣或免费升级额度。这并不意味着每个项目都能重新获得一份额度。比较两种策略:延长保留全部5,000条已评估 Trace,或只延长保留选定的1,000条。两种策略都接收100,000条 Trace,并产生5,000条评分。
| 计费项目 | 延长保留全部已评分 Trace | 延长保留选定子集 |
|---|---|---|
| 一个 Plus 席位 | $39.00 | $39.00 |
| 90,000个计费基础单位 | 90,000 × $0.005 = $450.00 | $450.00 |
| 计费升级单位 | 5,000 × $0.0025 = $12.50 | 1,000 × $0.0025 = $2.50 |
| 应用 Trace 费用加席位小计 | $501.50 | $491.50 |
两者相差10美元,并不意味着整张账单减少了80%。在本例中,选择性延长保留减少了80%的升级单位,但基础接收费用不变。从运营角度看,更重要的作用可能是:让长期保存的证据仅限于团队明确需要的 Trace。
base_units = max(100_000 - 10_000, 0)
seat_cost = 39
for upgrade_units in (5_000, 1_000):
    subtotal = seat_cost + base_units * 0.005 + upgrade_units * 0.0025
    print(f"USD {subtotal:.2f}")
# USD 501.50
# USD 491.50
这个计算假设升级发生在同一个计费月份,且没有历史回填、Thread 规则扩大范围或其他保留规则。基础数据接收与后续升级可能落在不同账期。应计算已升级 Trace ID 的并集,不能直接相加存在重叠的规则匹配数量。
10月的套餐迁移对已有合同、抵扣额度或特殊价格的账户存在例外。Enterprise 和自托管方案可能采用不含这项附加费的统一 Trace 费率。套用示例前,应确认账户的实际条款。上述数字是应用 Trace 的费用小计,并非完整的平台账单。评估器执行或其他工作负载产生的额外 Trace、模型调用、LLM 评分器用量、其他评估器服务、Deployment、Engine、税费和人员时间均未计入。若要计算整个业务工作流,应衡量每个通过验收的智能体结果的成本。
为什么 LangSmith 评估停止了,应用却还在运行?
Trace 数量限制与评估器支出上限控制的是不同操作。评分缺失需要解释,不能视为评估通过。
| 控制项 | 限制对象 | 预期结果 |
|---|---|---|
| 每月全部 Trace 上限 | Trace 接收数量 | 后续上传可能被拒绝;检查上传错误和429响应。 |
| 每月延长保留 Trace 上限 | 新增延长保留的 Trace | 需要新升级的操作被阻止;关闭延长保留的操作可以继续。 |
| 评估器每周支出上限 | 评估器在单个绑定上的 LLM 评分支出 | 该项目或数据集上的评分暂停;应用和 Trace 继续运行。 |
达到延长保留上限后,界面反馈和手动加入队列仍可继续,因为这些操作不会改变保留档位。关闭延长保留的评估器与规则也一样。Trace 数量限制只是近似限额,并不能限制所有 LangSmith 产品的支出,也不能限制模型提供商的账单。
评估器支出文档还说明了一个容易忽略的区别:组织默认预算按评估器与项目或数据集的每一项绑定分别继承。20美元的默认预算应用到三个绑定,不代表整个组织共用20美元预算。每个绑定都有自己的上限。
这些周限额在每周一00:00 UTC 重置。正在执行的评分可能造成小幅超额,且执行限额需要受支持的模型并配置好价格。遇到评分缺失时,应先检查绑定状态和评估器日志,再考虑修改筛选条件。为了绕过上限而调低模型估算价格,也会使支出记录失真。
Trace 到期后,LangSmith 数据集中的样例会一起删除吗?
不会。复制到数据集的样例有独立的生命周期。计费与保留期说明明确描述了将输入和输出存入数据集,以便源 Trace 到期后仍可使用。因此,14天的 Trace 保留策略并不等于这些内容的所有副本都会在14天后删除。
数据集历史版本同样需要考虑。根据LangSmith 的删除文档,软删除会保留历史版本;硬删除则会移除所选样例在各个历史版本中的输入、输出和元数据。删除应作为独立工作流,并有相应的验证步骤。
对每个筛选保留的样例,记录其用途、源 Trace ID、数据集及版本、负责人,以及复核或删除期限。保存一组输入和输出,并不会保留完整的嵌套 Trace 树。应保留事故调查或回归测试所需的具体证据,并验证跨过每个保留期边界后,还能访问哪些内容。
一套实用的 LangSmith 生产配置流程
以下是一套建议的上线顺序。应根据工作流的证据要求调整,并在正式依赖这些设置之前,用合成记录验证。
- 隔离环境,并为后续数据设定默认值。记录生产项目或智能体环境初始采用基础保留还是延长保留。将配置与应用版本一起保存。
- 确定哪些数据可以离开应用。在采样之前定义敏感数据排除规则。输入输出屏蔽控制不会自动移除所有元数据字段。评分器无法判断其输入中不存在的内容。应检查具有代表性的脱敏 Trace,以及评估器映射到的变量。
- 分别配置上传与评分。记录 SDK 采样率、根 Run 筛选条件、评估器采样率和每个绑定的支出上限。完整工作流的计数器应独立于采样后的 Trace 集合。
- 明确选择保留策略。如果工作流允许,可让常规评分使用基础保留,只为定义清楚的调查子集延长保留。检查所有重叠规则,包括 Thread 操作,并为人工审查设定期限。
- 验证预期状态变化。让合成的成功、错误和敏感输入案例经过预定路径。分别检查上传、评分、保留期和数据集副本。用实际接收的 Trace 数量和去重后的升级数量核对账单用量。
- 为证据缺失设置告警。监控上传错误、评估器失败、已暂停的绑定和评分覆盖率。明确谁负责即将到期的 Trace 以及数据集删除。
超出这些 LangSmith 设置的实施细节,可参阅我们的PII 脱敏管道指南。已经在现有 LiteLLM 技术栈中调查问题的团队,可以阅读独立的LiteLLM Lens Trace 分析指南。
成功上线后,团队应该能回答四个具体问题:记录了什么、评估了什么、需要证据时还会剩下什么,以及这些选择花了多少钱。Wavect 的AI 集成服务可以帮助你将这些配置与周边应用和审查流程连接起来。