专题
模型与基础设施
模型选择、推理经济性、本地部署、压缩与服务架构。
- 博客文章
- 80
- 主题
- AI 与智能体
从这里开始
本集合最新内容
 AI 与智能体
Cue 轮次检测:电话号码采集、基准测试与局限
停顿不代表电话号码已经说完。解析 Pype Cue v1 的实际改进、基准测量边界,以及正确采集和确认号码的测试方法。
 AI 与智能体
Google SAM 现名 Agent Mesh:跨机器调用 MCP 工具
跨机器连接已获授权的工具,理解控制平面与签名 EU 标签,并明确首次试点应通过哪些检查。
 AI 与智能体
EdgeQuake:用 PostgreSQL GraphRAG 构建 MCP 智能体记忆
让智能体检索文档之间的关系。基于 v0.34.0 核查 PostgreSQL 部署、MCP 访问权限、本地模型角色,以及 LightRAG 基准测试。
 AI 与智能体
BitNet CPU 推理:2B4T 的实际内存需求与 100B 说法
哪个 BitNet 模型可以下载,现有 CPU 又能运行哪个版本?厘清 100B 基准、0.4 GB 指标与 1.19 GB 文件的区别,再用实际任务评估。
 AI 与智能体
SuperPenguin:按 PR、客户和功能核算 AI 成本
Claude Code、Codex 和 Cursor 的费用该归到哪个 PR?产品 API 调用又属于哪位客户?了解 SuperPenguin 的成本归因、账单核对、定价和试点方法。
 AI 与智能体
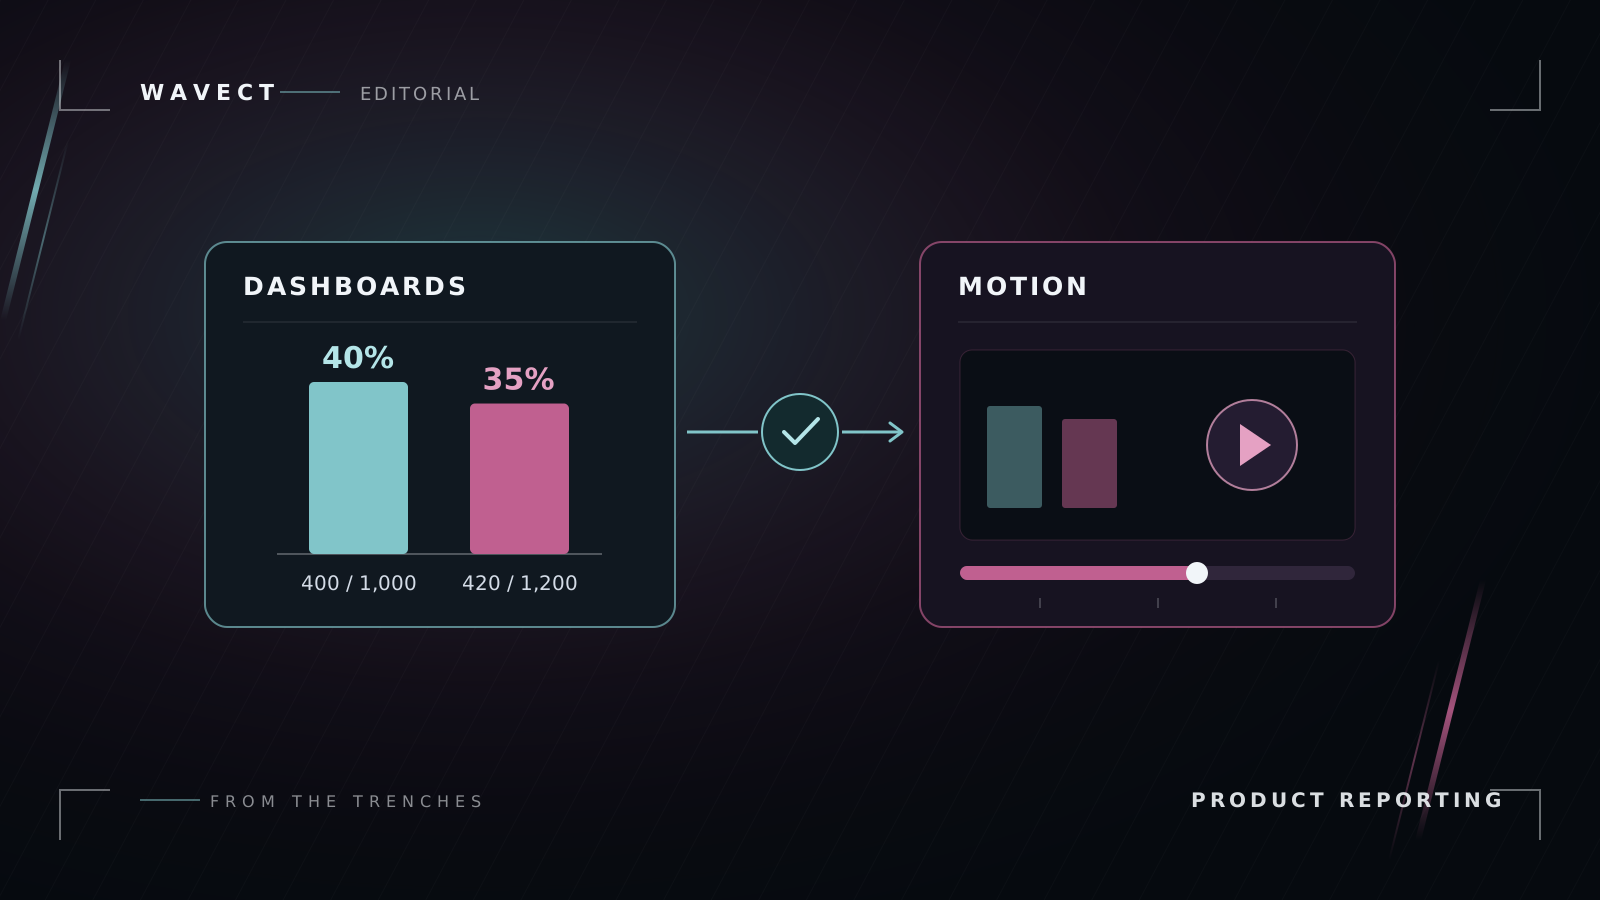
Claude Dashboards + Motion:把产品指标做成视频
把核查过的产品指标做成简短动画。通过一个分群示例、两个提示词和共享规则,了解 Claude Dashboards 与 Motion 的实际协作流程。
完整文章目录
- Cue 轮次检测:电话号码采集、基准测试与局限
- Google SAM 现名 Agent Mesh:跨机器调用 MCP 工具
- EdgeQuake:用 PostgreSQL GraphRAG 构建 MCP 智能体记忆
- BitNet CPU 推理:2B4T 的实际内存需求与 100B 说法
- SuperPenguin:按 PR、客户和功能核算 AI 成本
- Claude Dashboards + Motion:把产品指标做成视频
- OpenAI Intelligent UI 与 OpenUI:企业应用如何落地生成式 UI
- RunAnywhere Wally:按已验收编程任务计算成本
- Reducto 德语发票提取:测量人工复核成本
- OpenAI Decisions API:置信度、拒绝回答与任务路由
- Claude Model Router:到底何时切换模型?
- Cloudflare Clef 与 Jev:价格、基准测试与迁移
- Context Language Models 与上下文压缩:应该如何试点?
- Caveman 3.0 与 Claude Code:本地输入压缩、原文恢复与基准
- LiteLLM Lens:用 SQL 与 API 分析智能体 Trace
- SmythOS Studio 自托管指南:Docker、成本与部署边界
- DeerFlow 2.0:Docker 部署、沙箱与记忆机制
- CLM-8B 自托管:vLLM、动作缓存与验证器
- AnyJev:LLM 概率校准与选项顺序偏差
- LiteAgents SDK:逐轮模型路由、安装与迁移指南
- mcp-memory-service:让 Claude Code 与 Cursor 共享持久记忆
- Claude Opus 5.5 使用指南:适用场景、提示词与思考强度
- Laya 与 Jev 的企业应用:6 个实用工作流
- Laya vs Jev:基准结果与 AI 创业护城河
- Jev AI 评测:面向智能体工作流的决策模型
- SwarmLLM 评测 2026:手机与笔记本协同浏览器 LLM 推理
- Phonely Alma 评测:这款语音 LLM 能否用于生产?
- Utopia 企业评估:双时态知识图谱与历史问答
- NVIDIA PAIR 评测:本地 AI 路由与 AMD 支持缺口
- Tencent Hy4 Preview 评测:百万 Token 上下文值得试点吗?
- PageLM 评估:自托管与商业使用
- M6 Mac mini 对比 M5 Mac Studio:本地 AI 选购指南
- FreeToken AI 评测:消费级 GPU 能跑前沿 MoE 大模型吗?
- Darkbloom AI 评测:用闲置 Mac 提供私有推理
- Ox Alpha 已揭晓为 GLM-5.3-Flash:变化解读
- Pika Audio API 价格:SFX 真的便宜 20 倍吗?
- Thunder Compute 获 1300 万美元融资:企业 GPU 虚拟化采购指南
- AirLLM 只用 4GB 显存跑超大模型?逐层推理原理与代价
- Qwen3.8-27B:自托管电脑操作智能体,截图不出内网
- Netflix 的 vLLM 与 Triton 推理栈:7 个生产经验
- Transformers.js 浏览器本地 AI:什么时候适合放进产品
- LiteLLM 生产级自托管指南:2026 架构与安全
- AI 就绪企业 Wiki:架构与实施指南
- Claude 会给文本加水印吗?2026 API 实战解读
- OpenKB 评测:知识编译器 vs RAG
- Unsloth Desktop 评测:私有本地 AI 工作站?
- NeMo Switchyard 0.2:无需训练的智能体模型路由?
- Firecrawl AnyDoc 评测:14 种格式转 Markdown
- Muse Glimmer 30B:Meta 本地智能体模型能否用于生产?
- OmniRoute AI 路由:配置指南与生产检查清单
- Gemini Robotics 2:全身控制与试点决策
- pdf-inspector 评测:先本地解析 PDF,再调用 OCR
- 本地多模态 AI 编程助手:语音、OCR 与隐私架构
- 一台 AI PC 本地运行 DeepSeek V4 Flash 0731,现实效果如何?
- 用 Unsloth 和 Colab 免费微调 Gemma 4
- Taalas HC1 评测:硬编码 LLM ASIC 值得买吗?
- 你的硬件能运行哪个本地 LLM?llmfit 使用指南
- Miso TTS 本地部署对比 API:成本、延迟与显存真相
- 把 RAG 向量压缩到 2-bit:数据无关量化能上生产了吗?
- LMCache 报告共享 KV 缓存让平均 TTFT 降低 13.7 倍
- LLM 权重无损压缩 vs 8-bit GGUF:哪些已具备生产条件?
- NVIDIA Nemotron 3.5 ASR:免费自托管 STT 能否用于语音智能体?
- Kimi K3 企业评测:API 价格、数据合规与试点清单
- Mesh LLM 评测:一个大模型能否跨多台电脑运行?
- Bonsai 27B 评测:270 亿参数 LLM 真的能在手机上运行吗?
- Soofi S:德国主权大模型准备好商用了吗?
- Colibri 让消费级硬件跑起 GLM-5.2,代价是什么?
- 本地模型什么时候胜过 API:欧盟企业盈亏平衡计算器
- 2026 年 LLM 成本计算器:算任务,不算 Token
- Pxpipe 评测:图像能把 Claude Code 成本降低 60% 吗?
- 每 token 更便宜,每任务仍可能更贵
- Anthropic 不主张禁止开放权重。成本之争依然真实。
- 2026 年 DACH 地区的内部 AI 助手到底要花多少钱
- 2026 年 LLM 网关对比:LiteLLM vs OpenRouter vs Portkey vs RouteLLM
- 在欧盟自托管 LLM:开放权重模型何时才真正划算
- 2026 开放权重 LLM:DeepSeek、Qwen、Kimi、GLM、Llama 与 Muse
- 如何在 2026 年降低 LLM Token 成本
- 什么时候值得构建一套 LLM 评测?成本、ROI 与信任裁判
- 2026:RAG vs Fine-Tuning vs Long-Context
- 2026 LLM API 成本:架构要变
只收重要内容
获取下一篇关于AI 与智能体的一线笔记
有新文章时发送一封简短邮件,不使用跟踪像素,也不发送填充内容。