Decisiones prácticas sobre IA y software
Guías técnicas para elegir modelos, verificar software y planificar entregas.
Buscar en todos los artículos
Busca en el texto completo de los artículos.
Ningún artículo coincide con tu búsqueda. Prueba con otro término o elige un tema.
Artículos recientes
Nuevas comparaciones, guías prácticas y experiencias de ingeniería.
 Entrega y QA
Browser Use vs Playwright: Verificar acciones tras un timeout
Elige Browser Use o Playwright para flujos autenticados. Controla sesiones guardadas, envíos inciertos y reintentos con comprobaciones independientes.

 IA y agentes
OpenAI Decisions API: confianza, rechazos y enrutamiento
Guía de enrutamiento con la beta pública: solicitud de ejemplo, rechazos por pregunta, umbrales de probabilidad y un cálculo del coste de los tokens de entrada.
 IA y agentes
Claude Model Router: qué modelo cambia y cuándo
Una recomendación de modelo puede dejar intacta la sesión activa. Compara controles nativos, hooks de enrutamiento y pasarelas, y verifica qué modelo se ejecuta realmente.
 Entrega y QA
Software con IA: la ventaja competitiva está en operarlo bien
La IA hace que más software merezca la pena desarrollarse. El límite pasa a ser cuánto puedes mantener con fiabilidad: compara desarrollo propio y SaaS según sus costes y responsabilidades.
 IA y agentes
Cloudflare Clef vs. Jev: precios, pruebas y migración
Clef añade pesos abiertos e imágenes a una API de decisiones similar a Jev. Los precios, la confianza y los resultados de Flash exigen revisar bien la migración.
 IA y agentes
Context Language Models frente a compactación: qué probar
¿Debe su agente editar su propio contexto? Compare CLM y compactación, revise el harness y la licencia y pruebe qué ocurre cuando desaparecen datos esenciales.
 IA y agentes
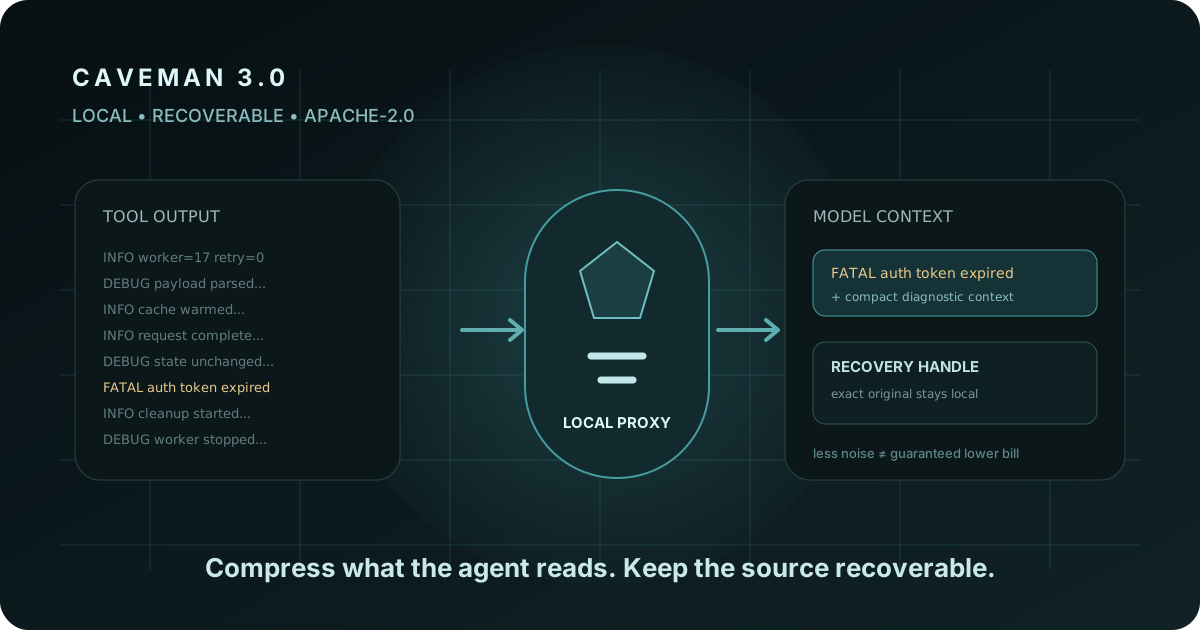
Caveman 3.0 para Claude Code: compresión local, recuperación y benchmarks
Caveman 3.0 coloca una capa Apache-2.0 entre el agente y el modelo. Analizamos el proxy, la recuperación, caveman learn y el benchmark de 33,2% menos tokens de entrada.
 IA y agentes
LiteLLM Lens: analizar trazas de agentes con SQL y APIs
Pasa de revisar ejecuciones aisladas a investigar patrones con evidencia: LiteLLM Lens, SQL sobre ClickHouse, acceso seguro y pruebas de regresión.
 Entrega y QA
ChatGPT Dots + GitHub: Del reporte de error al PR revisado
Convierte reportes en correcciones revisables, no en merges sin comprobar. Un flujo de Dots con encargo reutilizable, evidencias de pruebas y permisos claros.
Recibe la próxima nota de campo
Un correo breve cuando publiquemos. Sin píxeles de seguimiento ni contenido de relleno.