Praktische Entscheidungen für KI und Software
Technische Leitfäden zur Modellauswahl, Softwareprüfung und Projektplanung.
Alle Artikel durchsuchen
Durchsuche den gesamten Artikeltext.
Keine Beiträge zu deiner Suche. Probier einen anderen Begriff oder wähl ein Thema.
Neueste Artikel
Neue Vergleiche, praktische Leitfäden und Erfahrungen aus der Entwicklung.
 Software Delivery & QA
AgentMail im SaaS: Mandantentrennung und doppelte E-Mails
AgentMail mit mandantengebundenen Schlüsseln, dauerhaften Sendeabsichten und Wiederherstellung nach verlorenen Antworten integrieren. Mit vorgeschlagener Fehlermatrix.

 Produkt & MVP
Scope vs. Armature: API-Nutzung durch Agenten statt bloßer Erwähnungen
Scope und Armature für Agenten-Auffindbarkeit und API-Nutzbarkeit vergleichen. Installation, Anmeldung und erledigte Aufgaben mit konkreten Kaufkriterien prüfen.
 Software Delivery & QA
Browser Use vs. Playwright: Aktionen nach Timeouts sicher prüfen
Browser Use oder Playwright für authentifizierte Abläufe wählen. Gespeicherte Anmeldung, ungewisse Schreibaktionen und Wiederholungen unabhängig prüfen.
 KI & Agenten
OpenAI Decisions API: Konfidenz, Ablehnungen und Routing
Routing mit der öffentlichen Beta: Anfragebeispiel, Ablehnungen pro Frage, Wahrscheinlichkeitsschwellen und eine nachvollziehbare Kostenrechnung für Eingabe-Token.
 KI & Agenten
Claude Model Router: Wann wechselt welches Modell?
Eine Modellempfehlung kann die laufende Sitzung unverändert lassen. Vergleiche native Einstellungen, Routing-Hooks und Anbieter-Gateways und prüfe die tatsächliche Ausführung.
 Software Delivery & QA
KI-Code und Wettbewerbsvorteile: Wer betreibt die Software?
KI macht Software leichter nachbaubar. Warum verlässlicher Betrieb zum Wettbewerbsvorteil wird und welche Betriebskosten beim Bauen-oder-Kaufen-Vergleich zählen.
 KI & Agenten
Cloudflare Clef vs. Jev: Preise, Benchmarks und Migration
Clef ergänzt die Jev-artige Entscheidungs-API um offene Gewichte und Bilder. Preise, Confidence-Berechnung und Flash-Ergebnisse machen den Wechsel aber anspruchsvoller.
 KI & Agenten
Context Language Models vs. Kompaktierung: Was testen?
Soll dein Agent seinen Kontext selbst bearbeiten? Vergleiche CLMs mit Kompaktierung, prüfe Harness und Lizenz und teste den Erhalt wichtiger Fakten.
 KI & Agenten
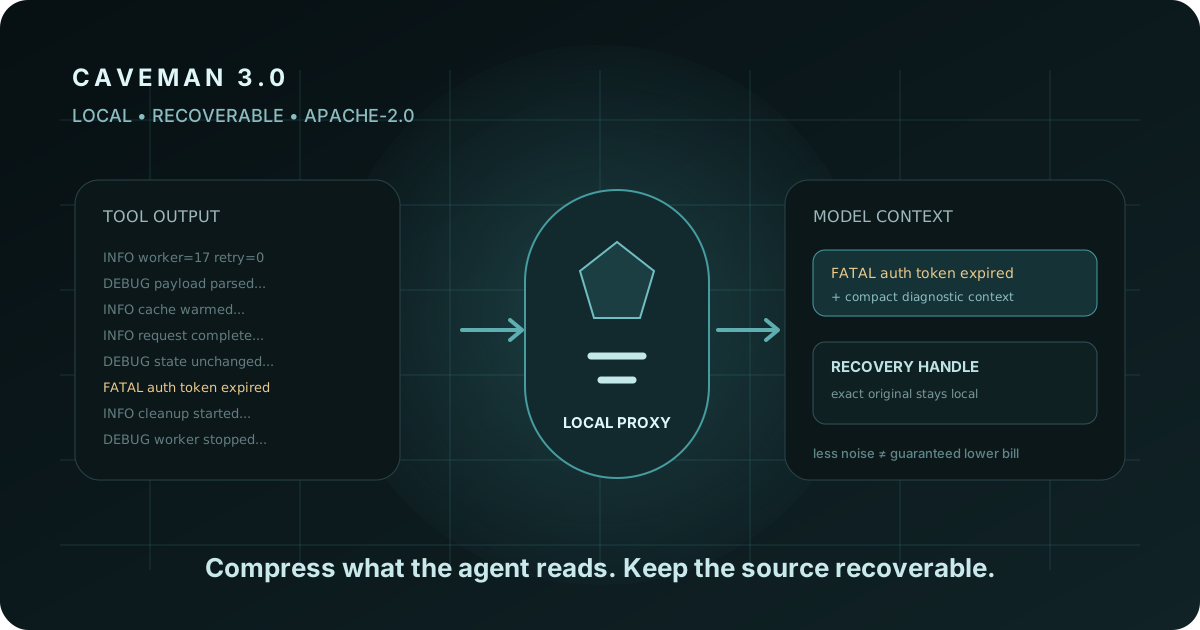
Caveman 3.0 für Claude Code: Lokale Input-Kompression, Recovery und Benchmarks
Caveman 3.0 setzt eine Apache-2.0-Kompressionsschicht zwischen Coding-Agent und Modell. Was Proxy, Recovery, Learn-Profiler und der gemeldete 33,2%-Benchmark wirklich zeigen.
Erhalte die nächste Feldnotiz
Eine kurze E-Mail, wenn wir veröffentlichen. Ohne Tracking-Pixel und ohne Postfachfüller.