Modelle und Infrastruktur
Modellauswahl, Inferenzkosten, lokaler Betrieb, Kompression und Serving-Architektur.
- Blogbeiträge
- 80
- Thema
- AI und Agents
Hier starten
Neu in dieser Sammlung
 KI & Agenten
Cue Turn Detection: Telefonnummern, Benchmarks und Grenzen
Eine Pause ist keine vollständige Telefonnummer. Was Pypes Cue v1 verbessert, wie die Benchmarks einzuordnen sind und welche Abnahmetests wirklich zählen.
 KI & Agenten
Google SAM heißt jetzt Agent Mesh: MCP-Tools vernetzen
Freigegebene Tools auf mehreren Rechnern verbinden: So funktionieren Control Plane, signierte EU-Labels und die Prüfungen für einen aussagekräftigen ersten Pilotversuch.
 KI & Agenten
EdgeQuake: PostgreSQL-GraphRAG als MCP-Gedächtnis für Agenten
EdgeQuake v0.34.0 für Dokumentenwissen: PostgreSQL-Betrieb, MCP-Berechtigungen, lokale Modellrollen und eine Einordnung der LightRAG-Benchmarks.
 KI & Agenten
BitNet auf der CPU: 2B4T, RAM-Bedarf und die 100B-Angabe
Welches BitNet-Modell kannst du herunterladen, und was passt auf deine CPU? Ordne den 100B-Benchmark, die 0,4-GB-Angabe und die 1,19-GB-Datei ein und prüfe eine echte Aufgabe.
 KI & Agenten
SuperPenguin: KI-Kosten pro PR, Kunde und Feature
Was kostet die Entwicklung eines Features, was seine Nutzung? So verbindet SuperPenguin Coding-Aktivität, Kundenmetadaten und Rechnungen zu belastbaren Kostennachweisen.
 KI & Agenten
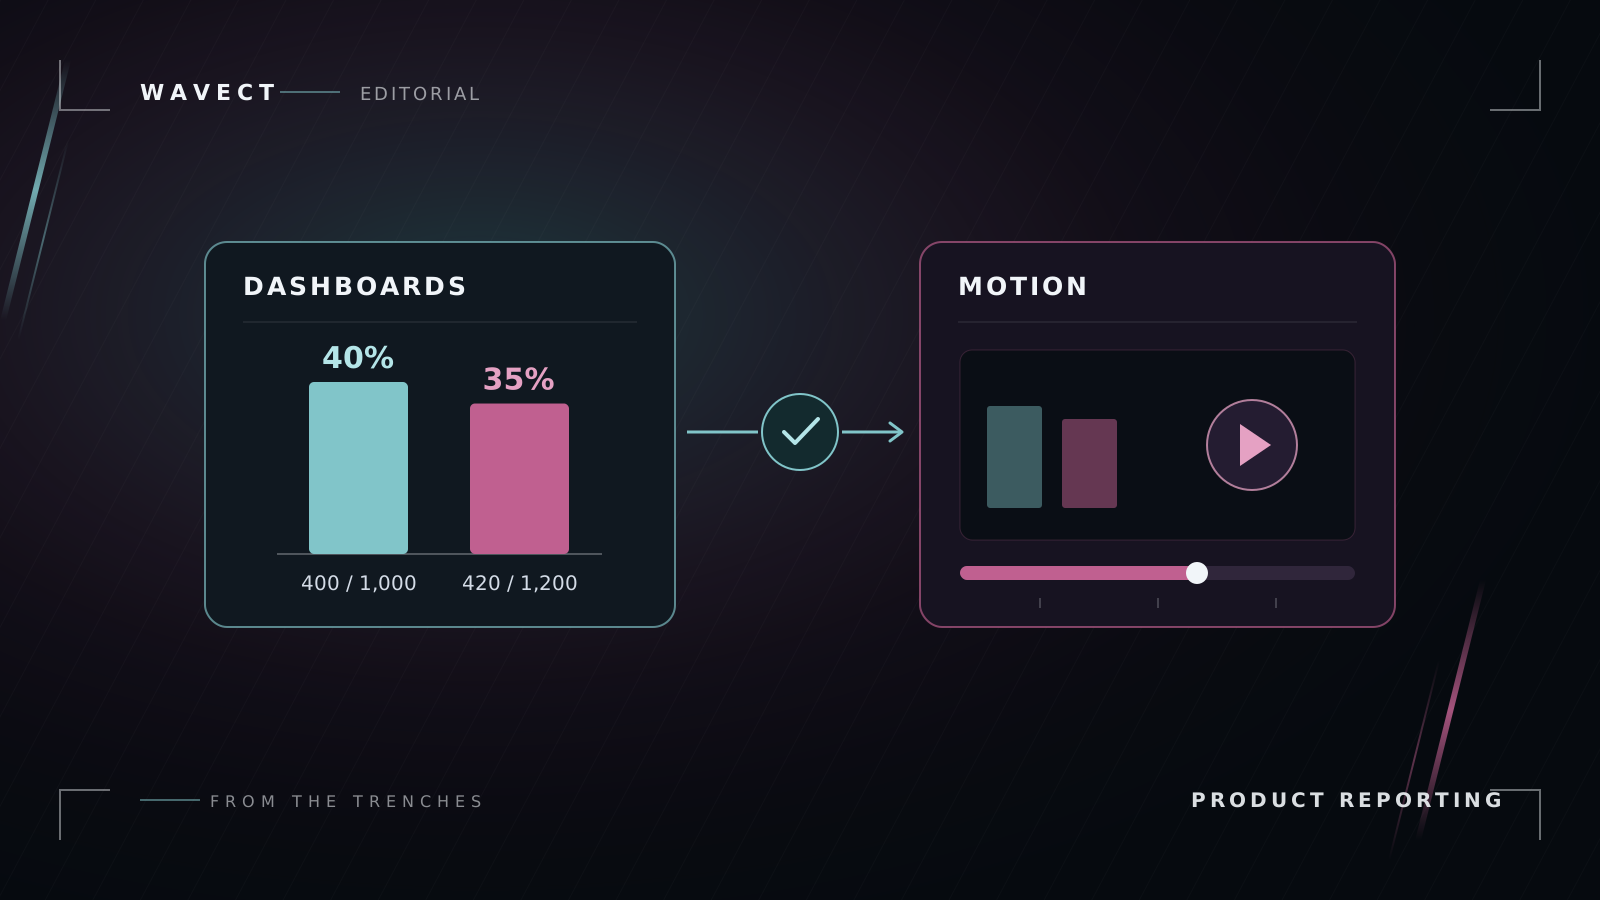
Claude Dashboards + Motion: Von KPIs zum Video
Aus einer geprüften Produktkennzahl wird ein kurzes animiertes Update. Ein konkreter Workflow mit Claude Dashboards und Motion, Kohortenbeispiel, zwei Prompts und Freigaberegeln.
Vollständiges Artikelverzeichnis
- Cue Turn Detection: Telefonnummern, Benchmarks und Grenzen
- Google SAM heißt jetzt Agent Mesh: MCP-Tools vernetzen
- EdgeQuake: PostgreSQL-GraphRAG als MCP-Gedächtnis für Agenten
- BitNet auf der CPU: 2B4T, RAM-Bedarf und die 100B-Angabe
- SuperPenguin: KI-Kosten pro PR, Kunde und Feature
- Claude Dashboards + Motion: Von KPIs zum Video
- OpenAI Intelligent UI vs. OpenUI: Generative UI für Business-Apps
- Wally von RunAnywhere: Kosten pro akzeptierter Coding-Aufgabe
- Reducto für deutsche Rechnungen: Nacharbeit richtig messen
- OpenAI Decisions API: Konfidenz, Ablehnungen und Routing
- Claude Model Router: Wann wechselt welches Modell?
- Cloudflare Clef vs. Jev: Preise, Benchmarks und Migration
- Context Language Models vs. Kompaktierung: Was testen?
- Caveman 3.0 für Claude Code: Lokale Input-Kompression, Recovery und Benchmarks
- LiteLLM Lens: Agenten-Traces mit SQL und APIs analysieren
- SmythOS Studio selbst hosten: Docker, Kosten und Grenzen
- DeerFlow 2.0: Docker-Setup, Sandboxes und Memory
- CLM-8B selbst hosten: vLLM, Action-Cache und Verifier
- AnyJev: LLM-Kalibrierung und Optionsreihenfolge
- LiteAgents SDK: Modell-Routing, Setup und Migration
- mcp-memory-service: Gemeinsames Gedächtnis für Claude Code und Cursor
- Claude Opus 5.5: Einsatzfälle, Prompts und Effort
- Laya und Jev im Unternehmen: 6 praktische Workflows
- Laya vs Jev: Benchmarks und das Risiko für KI-Startups
- Jev AI im Test: Entscheidungsmodelle für Agenten
- SwarmLLM Test 2026: Browser-P2P-Inferenz auf Smartphone und Laptop
- Phonely Alma im Test: Ist das Voice-LLM produktionsreif?
- Utopia: Temporalen Wissensgraph im Unternehmen prüfen
- NVIDIA PAIR im Test: Lokales KI-Routing und die AMD-Lücke
- Tencent Hy4 Preview im Test: Lohnt sich das 1M-Kontextmodell?
- PageLM im Check: Selbst hosten und kommerziell nutzen
- M6 Mac mini vs. M5 Mac Studio für lokale KI: Kaufberatung
- FreeToken AI im Test: Frontier-MoE auf Consumer-GPUs?
- Darkbloom AI Test: Private Inferenz auf freien Macs
- Ox Alpha als GLM-5.3-Flash enthüllt: Was sich ändert
- Pika Audio API Preise: Sind Soundeffekte wirklich 20x günstiger?
- Thunder Computes 13-Mio.-Dollar-Wette auf GPU-Virtualisierung: Einkaufsleitfaden
- AirLLM mit 4 GB VRAM: So funktioniert Layer-wise Inference
- Qwen3.8-27B: Computer-Use-Agenten selbst hosten, ohne Screenshots zu exportieren
- Der vLLM- und Triton-Stack von Netflix: 7 Produktionslektionen
- Transformers.js im Browser: Wann lokale KI in dein Produkt gehört
- LiteLLM selbst hosten: Production-Guide 2026
- KI-fähiges Unternehmenswiki: Architektur und Aufbau
- Versieht Claude Texte mit Wasserzeichen? API-Antwort 2026
- OpenKB Review: Knowledge Compiler vs. RAG
- Unsloth Desktop im Test: Private lokale KI-Workstation?
- NeMo Switchyard 0.2: Agenten-Routing ohne Training?
- Firecrawl AnyDoc im Test: 14 Formate zu Markdown
- Muse Glimmer 30B: Ist Metas lokales Agentenmodell produktionsreif?
- OmniRoute KI-Routing: Setup und Produktions-Checkliste
- Gemini Robotics 2: Ganzkörpersteuerung und die Pilotentscheidung
- pdf-inspector im Test: PDFs vor OCR lokal routen
- Lokaler multimodaler KI-Coding-Assistent: Sprache, OCR und Datenschutz
- DeepSeek V4 Flash 0731 auf einem KI-PC: Was funktioniert?
- Gemma 4 kostenlos mit Unsloth und Colab tunen
- Taalas HC1 im Check: Lohnt sich ein fest verdrahteter LLM-ASIC?
- Welches lokale LLM läuft auf deiner Hardware? llmfit Guide
- Miso TTS selbst hosten oder API: Kosten, Latenz und VRAM
- RAG-Vektoren auf 2 Bit komprimieren: Ist datenunabhängige Quantisierung produktionsreif?
- LMCache meldet 13,7x niedrigere mittlere TTFT mit gemeinsamem KV Cache
- Verlustfreie LLM-Kompression vs. 8-bit GGUF: Was ist produktionsreif?
- NVIDIA Nemotron 3.5 ASR: Ist Self-Hosted STT bereit für Voice Agents?
- Kimi K3 für EU-Unternehmen: API-Kosten, Datenschutz und Pilotplan
- Mesh LLM im Test: Ein großes LLM auf mehreren Rechnern ausführen?
- Bonsai 27B im Test: Läuft ein 27B-LLM wirklich auf dem Smartphone?
- Soofi S: Ist Deutschlands souveränes LLM bereit für Unternehmen?
- Colibri führt GLM-5.2 auf Consumer-Hardware aus. Der Haken.
- Wann lokale Modelle APIs schlagen: Break-even-Rechner für EU-Unternehmen
- LLM-Kostenrechner 2026: Rechne pro Aufgabe, nicht pro Token
- Pxpipe im Test: Senken Bilder Claude-Code-Kosten um 60%?
- Pro Token günstiger kann pro Aufgabe teurer sein
- Anthropic sagt Nein zum Open-Weights-Verbot. Der Kostenkampf bleibt real.
- Was ein interner KI-Assistent in der DACH-Region wirklich kostet (2026)
- LLM-Gateways im Vergleich 2026: LiteLLM vs OpenRouter vs Portkey vs RouteLLM
- LLMs in der EU selbst hosten: Wann sich Open Weights wirklich rechnen
- Open-Weight-LLMs 2026: DeepSeek, Qwen, Kimi, GLM, Llama und Muse
- LLM-Token-Kosten 2026 senken
- Wann lohnt es sich, ein LLM-Eval zu bauen? Kosten, ROI und dem Judge vertrauen
- RAG, Fine-Tuning oder Long Context? Vergleich 2026
- LLM-API-Kosten 2026. Architektur-Shift
Erhalte die nächste Feldnotiz zu AI und Agents
Eine kurze E-Mail, wenn wir veröffentlichen. Ohne Tracking-Pixel und ohne Postfachfüller.